大型互联网公司一般都会要求消息传递最大限度的不丢失,比如用户服务给代金券服务发送一个消息,如果消息丢失会造成用户未收到应得的代金券,最终用户会投诉。
为避免上面类似情况的发生,除了做好补偿措施,更应该在系设计的时候充分考虑各种异常,设计一个稳定、高可用的消息系统。
认识 Kafka
看一下维基百科的定义
Kafka 是分布式发布-订阅消息系统。
它最初由 LinkedIn 公司开发,之后成为 Apache 项目的一部分。
Kafka 是一个分布式的,可划分的,冗余备份的持久性的日志服务。它主要用于处理活跃的流式数据。
kafka 架构
Kafka 的整体架构非常简单,是显式分布式架构,主要由 producer、broker(kafka)和 consumer 组成。
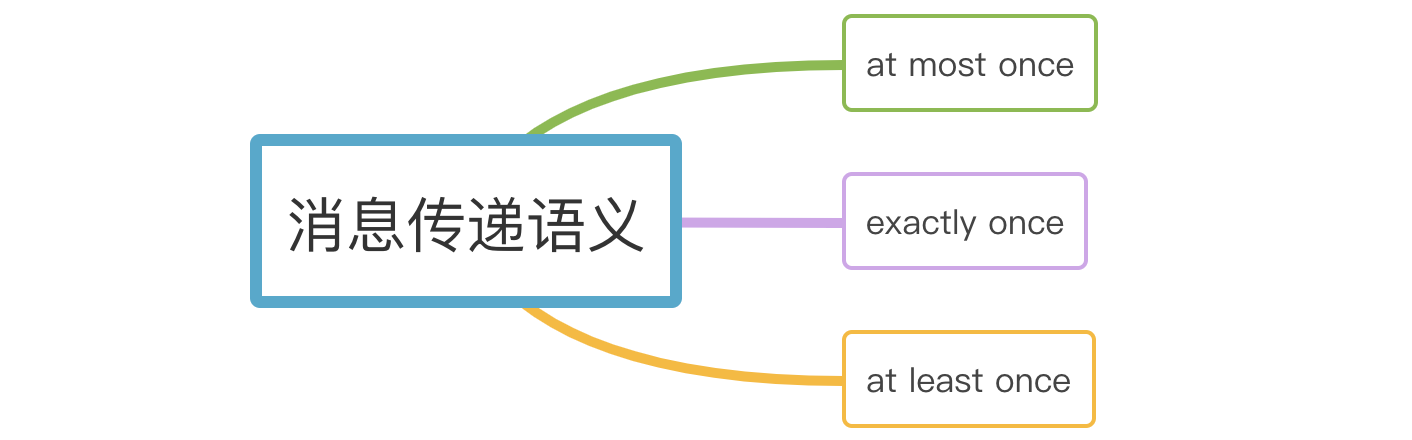
Producer(生产者)可以将数据发布到所选择的 topic(主题)中。生产者负责将记录分配到 topic 的哪一个 partition(分区)中。可以使用循环的方式来简单地实现负载均衡,也可以根据某些语义分区函数(如记录中的 key)来完成。
Consumer(消费者)使用一个 consumer group(消费组)名称来进行标识,发布到 topic 中的每条记录被分配给订阅消费组中的一个消费者实例。消费者实例可以分布在多个进程中或者多个机器上。
Kafka 到底会不会丢失消息?
在讨论 kafka 是否丢消息前先来了解一下什么是消息传递语义。
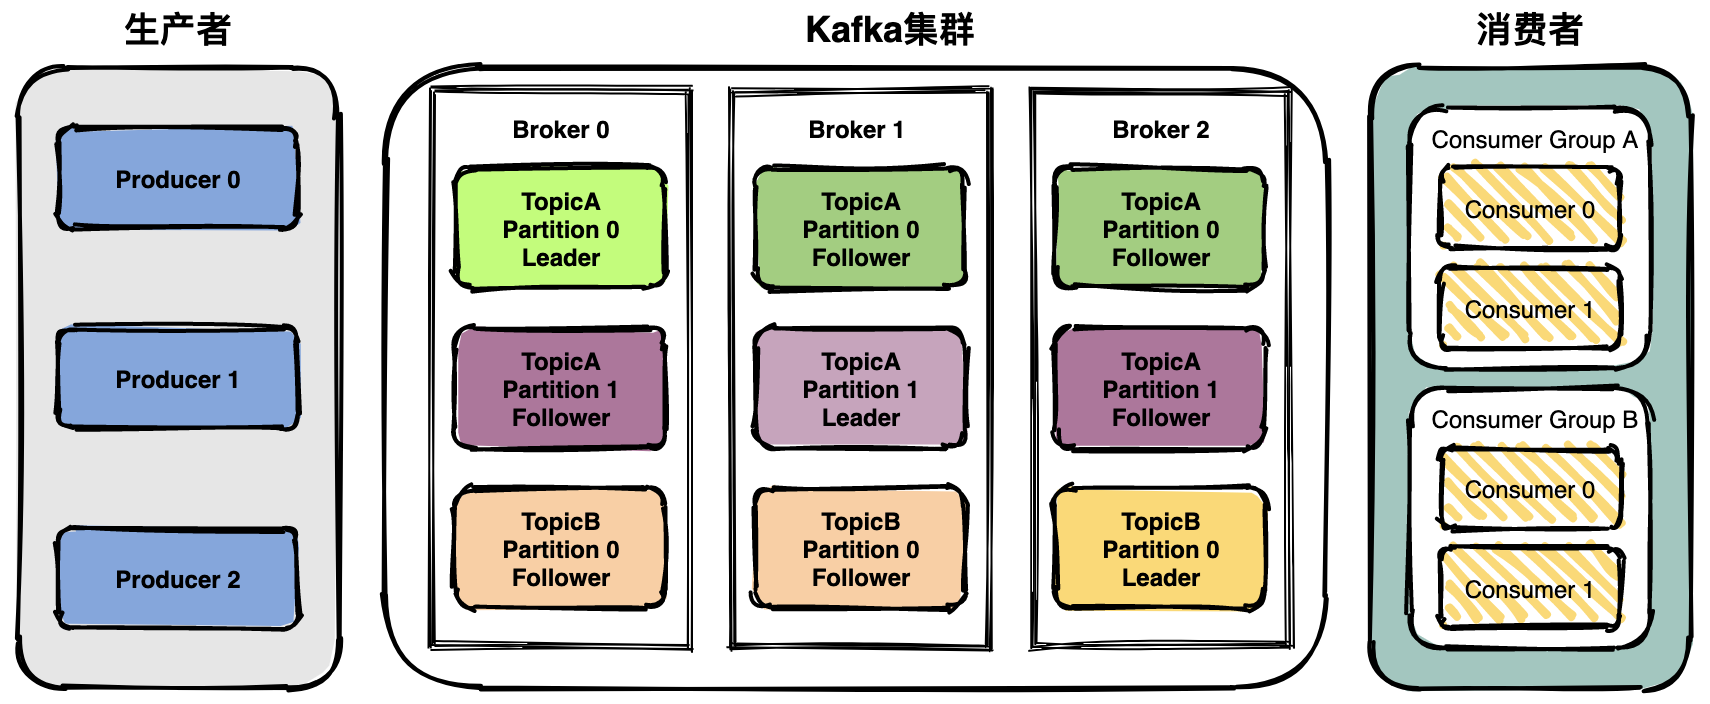
message delivery semantic 也就是消息传递语义,简单说就是消息传递过程中消息传递的保证性。主要分为三种:
at most once:最多一次。消息可能丢失也可能被处理,但最多只会被处理一次。
at least once:至少一次。消息不会丢失,但可能被处理多次。可能重复,不会丢失。
exactly once:精确传递一次。消息被处理且只会被处理一次。不丢失不重复就一次。
理想情况下肯定是希望系统的消息传递是严格 exactly once,也就是保证不丢失、只会被处理一次,但是很难做到。
回到主角 Kafka,Kafka 有三次消息传递的过程:
生产者发消息给 Kafka Broker。
Kafka Broker 消息同步和持久化
Kafka Broker 将消息传递给消费者。
在这三步中每一步都有可能会丢失消息,下面详细分析为什么会丢消息,如何最大限度避免丢失消息。
生产者丢失消息
先介绍一下生产者发送消息的一般流程(部分流程与具体配置项强相关,这里先忽略):
生产者是与 leader 直接交互,所以先从集群获取 topic 对应分区的 leader 元数据;
获取到 leader 分区元数据后直接将消息发给过去;
Kafka Broker 对应的 leader 分区收到消息后写入文件持久化;
Follower 拉取 Leader 消息与 Leader 的数据保持一致;
Follower 消息拉取完毕需要给 Leader 回复 ACK 确认消息;
Kafka Leader 和 Follower 分区同步完,Leader 分区会给生产者回复 ACK 确认消息。
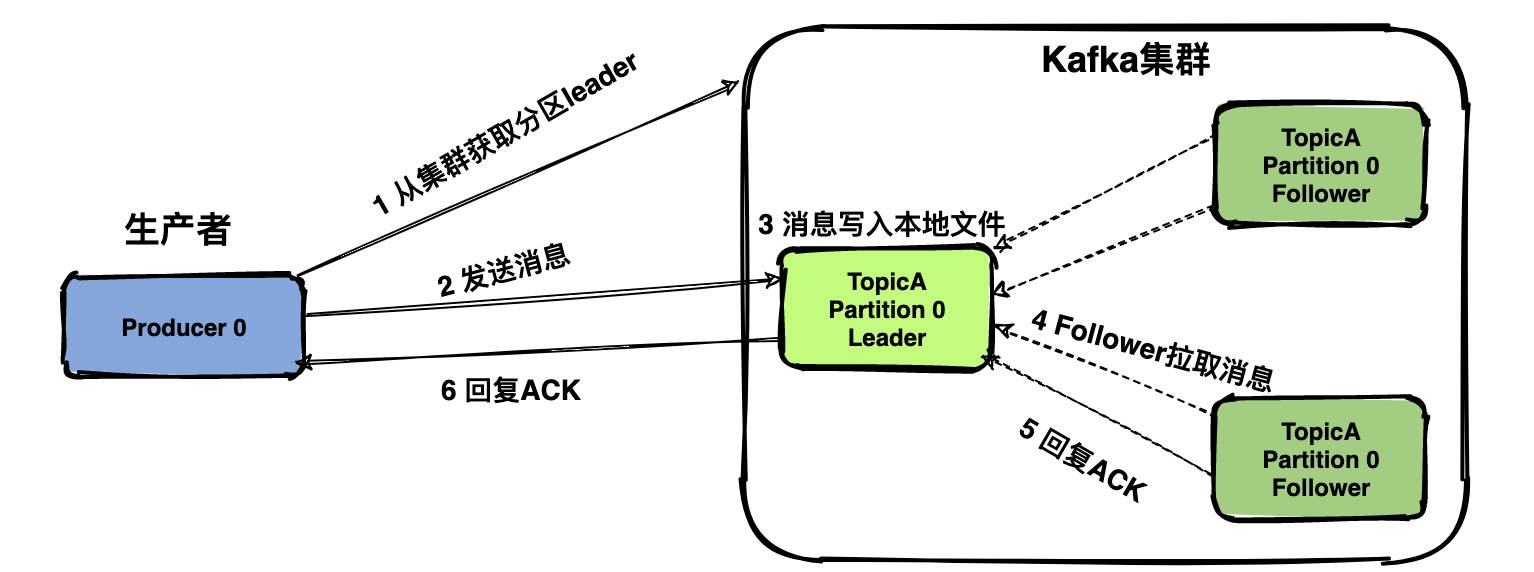
生产者采用 push 模式将数据发布到 broker,每条消息追加到分区中,顺序写入磁盘。消息写入 Leader 后,Follower 是主动与 Leader 进行同步。
Kafka 消息发送有两种方式:同步(sync)和异步(async),默认是同步方式,可通过 producer.type 属性进行配置。
Kafka 通过配置 request.required.acks 属性来确认消息的生产:
0 表示不进行消息接收是否成功的确认;不能保证消息是否发送成功,生成环境基本不会用。
1 表示当 Leader 接收成功时确认;只要 Leader 存活就可以保证不丢失,保证了吞吐量。
-1 或者 all 表示 Leader 和 Follower 都接收成功时确认;可以最大限度保证消息不丢失,但是吞吐量低。
kafka producer 的参数 acks 的默认值为 1,所以默认的 producer 级别是 at least once,并不能 exactly once。
敲黑板了,这里可能会丢消息的!
如果 acks 配置为 0,发生网络抖动消息丢了,生产者不校验 ACK 自然就不知道丢了。
如果 acks 配置为 1 保证 leader 不丢,但是如果 leader 挂了,恰好选了一个没有 ACK 的 follower,那也丢了。
all:保证 leader 和 follower 不丢,但是如果网络拥塞,没有收到 ACK,会有重复发的问题。
Kafka Broker 丢失消息
Kafka Broker 接收到数据后会将数据进行持久化存储,你以为是下面这样的:
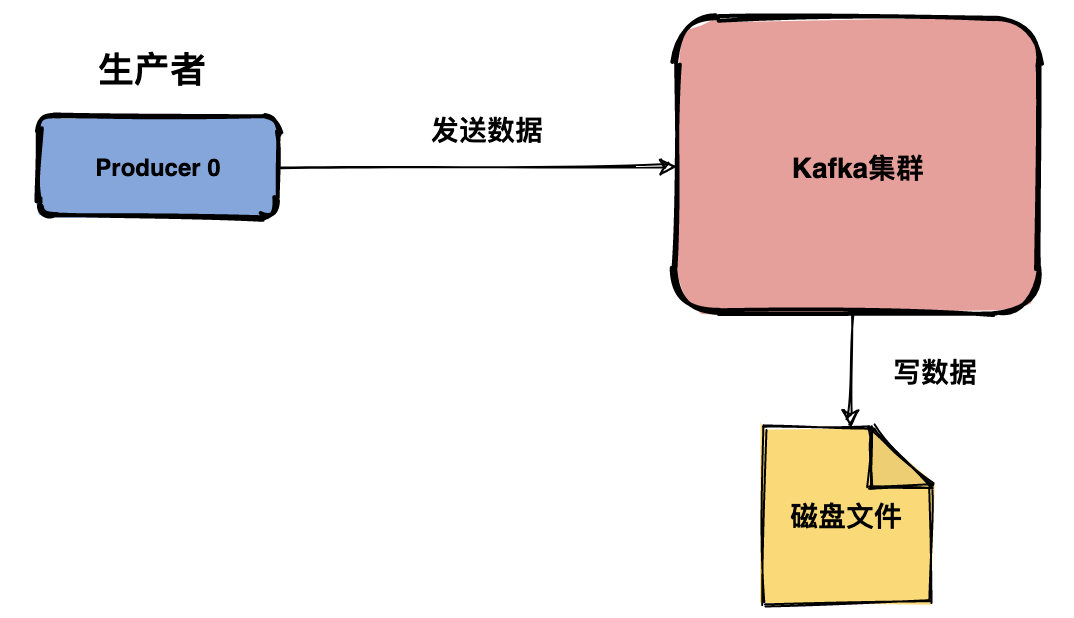
没想到是这样的:
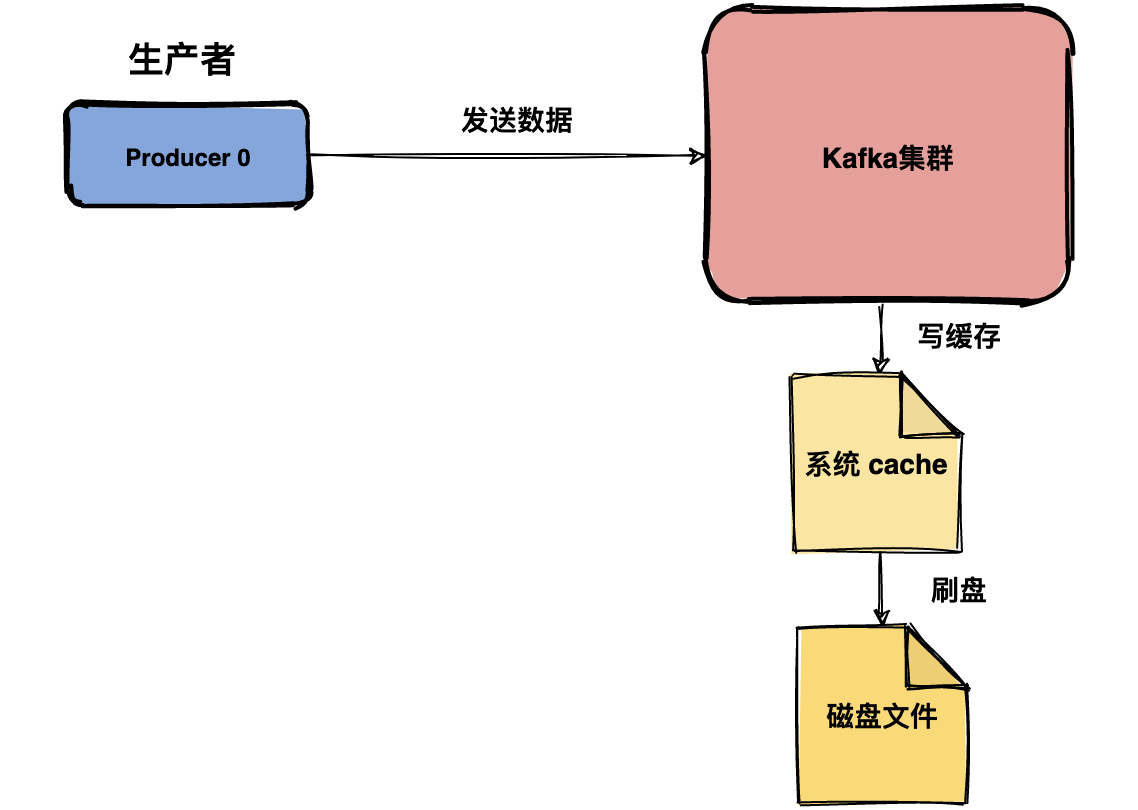
操作系统本身有一层缓存,叫做 Page Cache,当往磁盘文件写入的时候,系统会先将数据流写入缓存中,至于什么时候将缓存的数据写入文件中是由操作系统自行决定。
Kafka 提供了一个参数 producer.type 来控制是不是主动 flush,如果 Kafka 写入到 mmap 之后就立即 flush 然后再返回 Producer 叫同步 (sync);写入 mmap 之后立即返回 Producer 不调用 flush 叫异步 (async)。
敲黑板了,这里可能会丢消息的!
Kafka 通过多分区多副本机制中已经能最大限度保证数据不会丢失,如果数据已经写入系统 cache 中但是还没来得及刷入磁盘,此时突然机器宕机或者掉电那就丢了,当然这种情况很极端。
消费者丢失消息
消费者通过 pull 模式主动的去 kafka 集群拉取消息,与 producer 相同的是,消费者在拉取消息的时候也是找 leader 分区去拉取。
多个消费者可以组成一个消费者组(consumer group),每个消费者组都有一个组 id。同一个消费组者的消费者可以消费同一 topic 下不同分区的数据,但是不会出现多个消费者消费同一分区的数据。
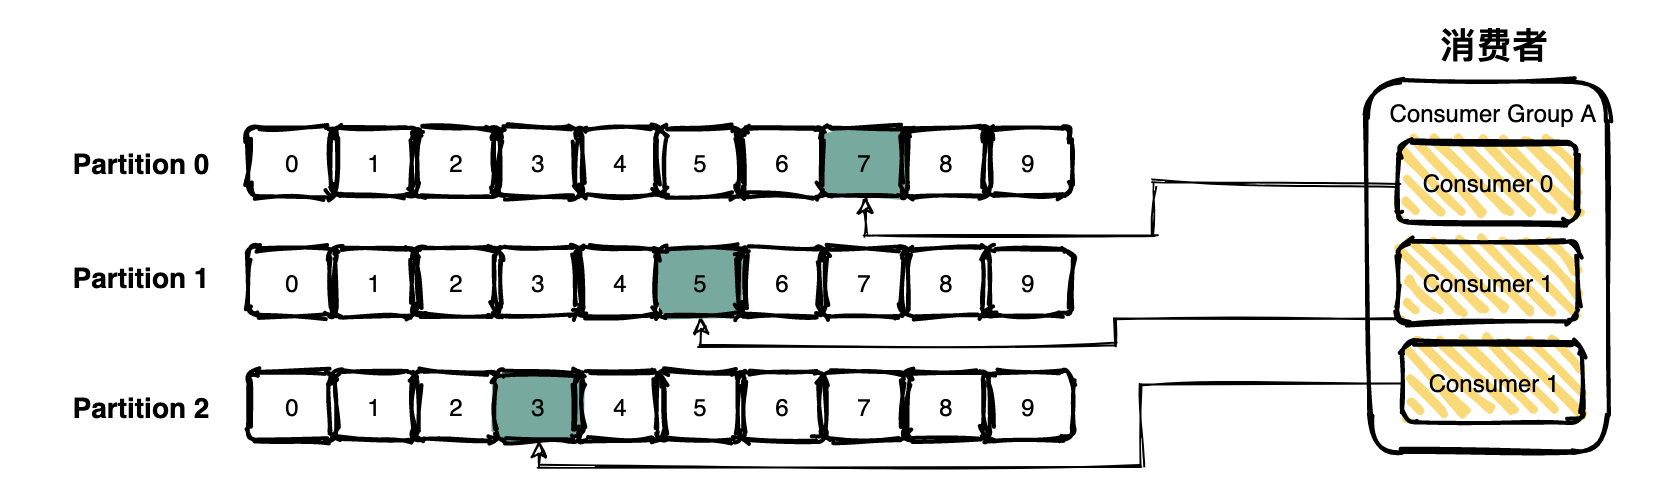
消费者消费的进度通过 offset 保存在 kafka 集群的__consumer_offsets 这个 topic 中。
消费消息的时候主要分为两个阶段:
1、标识消息已被消费,commit offset 坐标;
2、处理消息。
敲黑板了,这里可能会丢消息的!
场景一:先 commit 再处理消息。如果在处理消息的时候异常了,但是 offset 已经提交了,这条消息对于该消费者来说就是丢失了,再也不会消费到了。
场景二:先处理消息再 commit。如果在 commit 之前发生异常,下次还会消费到该消息,重复消费的问题可以通过业务保证消息幂等性来解决。
总结
那么问题来了,kafka 到底会不会丢消息?答案是:会!
Kafka 可能会在三个阶段丢失消息:
(1)生产者发送数据;
(2)Kafka Broker 存储数据;
(3)消费者消费数据;
在生产环境中严格做到 exactly once 其实是难的,同时也会牺牲效率和吞吐量,最佳实践是业务侧做好补偿机制,万一出现消息丢失可以兜底。
• Kafka 靠 多副本 + ISR + 幂等生产 + 手动提交 四层保险保证消息可靠性。
Kafka “消息不丢” 6 把锁
| 层级 | 风险场景 | Kafka 给的“锁” | 一句话记忆 |
|---|---|---|---|
| 1 生产者 | 客户端崩溃 → 消息还在内存 | acks=all + 幂等 enable.idempotence=true + 重试 | “把消息写到所有 ISR 才算完” |
| 2 Broker | 单个节点掉电 → 页缓存未落盘 | log.flush.interval.messages=1(同步刷盘)或 Replication | “要么同步刷盘,要么有备胎” |
| 3 Broker | Leader 挂了 → 数据没同步完 | ISR 机制 + 最小同步副本 min.insync.replicas | “备胎数量不够就拒绝写” |
| 4 Broker | 磁盘坏道 → 文件损坏 | 分段日志 + CRC32 校验,损坏段自动截断 | “每段自带体检报告” |
| 5 消费者 | 处理完还没来得及提交 offset | 手动 commit + 幂等消费(业务去重表 / 唯一键) | “先干活再打卡,打卡失败可重试” |
| 6 整集群 | 机房级故障 | MirrorMaker 2 / 跨集群复制 | “异地双活” |
最小可靠配置示例
# 生产者
acks=all
retries=Integer.MAX_VALUE
enable.idempotence=true
max.in.flight.requests.per.connection=5

# Broker
min.insync.replicas=2
unclean.leader.election=false

# 消费者
enable.auto.commit=false
isolation.level=read_committed   # 配合事务
二、用 ZooKeeper 可以做的 7 件“分布式脏活累活”
ZK 本质是一个 带监听功能的小文件系统 + 强一致广播机。凡是“多个进程抢同一把锁、同一条配置、同一条元数据”的场景都能用。
| 场景 | ZooKeeper 技术点 | 一句话解释 |
|---|---|---|
| 1 服务注册发现 | 临时顺序节点 + Watcher | 节点挂掉自动删,客户端实时收到通知 |
| 2 分布式锁 | 临时顺序节点 + 监听前一个节点 | 谁序号最小谁拿到锁 |
| 3 Master 选主 | 创建 /master 临时节点,成功即当选,失败则监听删除事件 | 主节点挂掉秒级重新选举 |
| 4 配置中心 | 把配置写到 ZNode,监听数据变化 | 配置一改,所有节点热刷新 |
| 5 分布式队列 | 顺序节点做 FIFO / 优先级队列 | 生产者写节点,消费者监听子节点列表 |
| 6 Barrier 栅栏 | 所有客户端在某个父节点下建子节点,计数到达阈值后一起放行 | 分布式任务同步起跑 |
| 7 元数据/命名服务 | 统一命名空间,路径即名字 | 比如 Kafka 把 Broker 列表、Topic 分区信息都放 ZK |
代码片段:分布式锁(Curator 版)
InterProcessMutex lock = new InterProcessMutex(client, "/locks/pay");
if (lock.acquire(10, TimeUnit.SECONDS)) {
    try {
        // 执行业务
    } finally {
        lock.release();
    }
}
总结一句话
• Kafka 靠 多副本 + ISR + 幂等生产 + 手动提交 四层保险保证消息可靠性。
• ZooKeeper 像“分布式班长”,凡是抢锁、选主、发通知、存配置的活都能干。